Inovio Hub
Die Herausforderung
Inovio doo kauft bei Distributoren ein und verkauft über Marktplätze, Partner und den eigenen Shop. Übliche E-Commerce-Software geht davon aus, dass ein Produkt einen Lieferanten und einen Preis hat. Hier hat es mehrere von beidem, und jeder Kanal hat seine eigenen Handelskonditionen. Der alte Katalog konnte das nicht abbilden, also glichen Mitarbeiter die Lücke von Hand aus. Der Aufwand wuchs mit Lieferanten mal Kanälen und begrenzte damit, wie viel das Unternehmen annehmen konnte.
Unser Ansatz
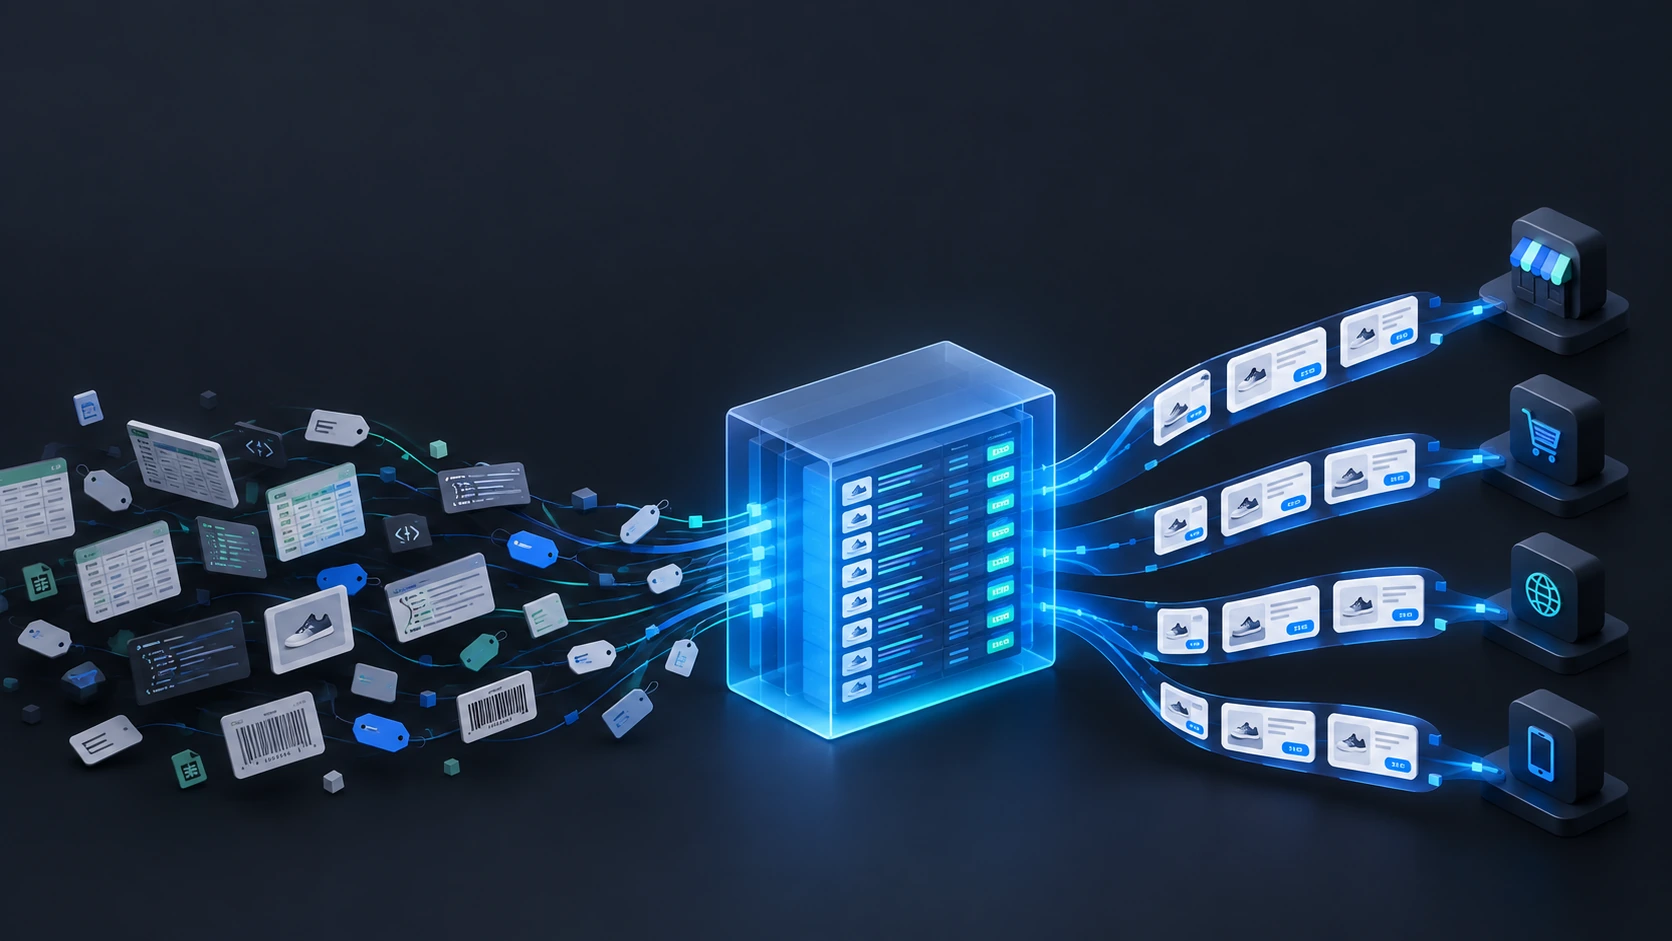
Wir haben eine Plattform gebaut, in der der Katalog die einzige Quelle der Wahrheit ist und jedes externe System hinter einem Adapter sitzt. Lieferanten-Feeds werden in ein internes Schema überführt, egal in welchem Format sie ankommen. Jeder Vertriebskanal wird aus demselben Schema gespeist. Eine Preis-Engine berechnet den Preis, der veröffentlicht wird, sodass auf dem Weg nach draußen nichts neu berechnet wird, und der Bestand wird an einer Stelle ermittelt. Ein KI-Anreicherungsservice füllt die Felder, die die Feeds nicht liefern, und ein Mensch genehmigt seine Vorschläge, bevor sie übernommen werden. Das Backoffice ist ein kompaktes Arbeitswerkzeug für Leute, die den ganzen Tag lange Tabellen überfliegen, und keine Marketingfläche.
Ergebnisse
Seit Ende 2025 im Produktivbetrieb und in kontinuierlicher Auslieferung. Die Migration hat die Produktcodes behalten, die die Vertriebskanäle bereits hinterlegt hatten, sodass nichts neu gelistet werden musste. Ein neuer Lieferant oder Kanal ist jetzt eine abgegrenzte Aufgabe und keine Änderung mehr, die sich durch Preise, Bestand und jede bestehende Integration zieht. Dateneingaben, die früher in einer Warteschlange lagen, kommen jetzt als Vorschläge an, die ein Operator genehmigt.
- 4.703 automatisierte Tests in 461 Testdateien
- 106.000 Zeilen Testcode gegenüber 109.000 Zeilen Anwendungscode
- 164 API-Endpunkte und 199 Backoffice-Komponenten
- 288 Tickets geliefert in 559 Commits
- 23 Architecture Decision Records und 90 Seiten Dokumentation
- 9 Monate kontinuierliche Auslieferung, läuft weiter
Was die Zeit gekostet hat
Die schwierigen Teile waren nicht die, die irgendjemand geschätzt hatte.
Die Preisgestaltung war der erste. Sobald ein Produkt bei mehreren Distributoren gekauft und über mehrere Kanäle verkauft werden kann, ist der Preis kein Feld mehr, sondern eine Berechnung. Das System, das wir übernommen haben, machte es schlimmer, indem es Preise in dem Code neu berechnete, der jeden Feed erzeugte, sodass die Zahl in der Datenbank und die Zahl auf dem Marktplatz voneinander abweichen konnten und niemand sagen konnte, welche richtig war. Wir haben all das in eine Engine verlagert. Als wir die letzten dieser Umschreibungen zum Exportzeitpunkt entfernten, bewegten sich einige veröffentlichte Preise. Das Gespräch darüber war unangenehm, aber richtig.
Identifikatoren waren der zweite, und wir haben sie unterschätzt. Jeder Vertriebskanal kannte den Katalog bereits unter den Codes, die das alte System vergeben hatte, und diese Codes liegen in den Datenbanken anderer Unternehmen, verknüpft mit Listing-Historie. Neue, saubere Codes hätten bedeutet, alles von Grund auf neu zu listen. Also hört ein migriertes Produkt überall dort weiter auf seinen alten Code, wo ein Kanal ihn bereits kennt, und trägt überall sonst einen neuen internen.
Als um vier Uhr morgens etwas kaputtging
Ein geplanter Feed-Job brachte den Worker an die Speichergrenze. Bei jedem Wiederholungsversuch stieg der Verbrauch auf fast drei Gigabyte.
Die Ursache war banal und ganz allein unsere Schuld. Der Export baute den gesamten Feed als einen String im Speicher auf, die Komprimierung hielt das Original am Leben, und ein Fehler später beim Upload verhinderte, dass irgendetwas davon freigegeben wurde, während die Warteschlange es erneut versuchte.
Nichts Kundenseitiges fiel aus, und genau dafür trennt man Hintergrundarbeit ab. Aber der Feed ging nicht raus, und er wäre in der nächsten Nacht wieder gescheitert. Wir haben den Pfad auf Streaming umgeschrieben: ein Datenbank-Cursor, der einen XML-Writer speist, auch Komprimierung und Upload streamen, statt zu puffern. Dann haben wir den Container-Speicher gedeckelt, die Wiederholungsversuche für diesen Job-Typ reduziert und Ursache und Zeitablauf schriftlich festgehalten.
Wir zeigen einem potenziellen Kunden lieber das als eine makellose Statusseite. Fragen Sie den, der Ihr System baut, wie schnell er erfährt, dass etwas kaputtgeht, und was es danach außer einem Fix gibt.
Wie es läuft
Deploys gehen aus der CI als Container mit Speicherlimits raus, sodass eine einzelne schlechte Workload nicht den Host mitreißen kann. Hintergrundarbeit läuft über eine Redis-gestützte Warteschlange mit Dashboard. Logs sind strukturiert und durchsuchbar, Fehler gehen an Sentry, und eingehende Lieferanten-Feeds sitzen hinter einem Circuit Breaker, sodass ein Distributor, der einen schlechten Morgen hat, eine Pause bekommt, statt bis zum Zusammenbruch erneut abgefragt zu werden.
Am meisten nutzen die Operatoren das Ausführungsprotokoll. Jede Synchronisation und jeder Feed-Export hält Statistiken, Dauer, Auslöser und Ergebnis fest. Warnungen werden absichtlich getrennt von Fehlern gezählt, sodass ein Lauf, der durchgelaufen ist, aber etwas Erwähnenswertes getan hat, trotzdem als sauber gilt. Macht man das falsch, steht das Dashboard dauerhaft auf Gelb, und die Leute hören auf hinzusehen.
Was Sie neben der Software bekommen
Dreiundzwanzig schriftliche Architekturentscheidungen, neunzig Seiten Dokumentation und ein Glossar, das festlegt, was jeder Begriff in der Domäne bedeutet. Das klingt bürokratisch. Aber deshalb kann eine neue Person in dieser Codebasis schon nach einer Woche sinnvoll mitarbeiten.
Und Tests, im oben genannten Verhältnis: ungefähr so viel Testcode wie Anwendungscode. In einem System wie diesem zeigt sich ein stiller Bug in Preisen oder Bestand nicht als Fehler. Er zeigt sich Wochen später als falsche Zahl auf einem fremden Marktplatz.